A Era da IA Agêntica: Por Que as GPUs Não São Mais o Único Foco da Infraestrutura de TI
Entenda por que a transição de chatbots reativos para fluxos autônomos de múltiplos agentes está equilibrando a balança entre CPUs potentes e GPUs nos datacenters modernos.
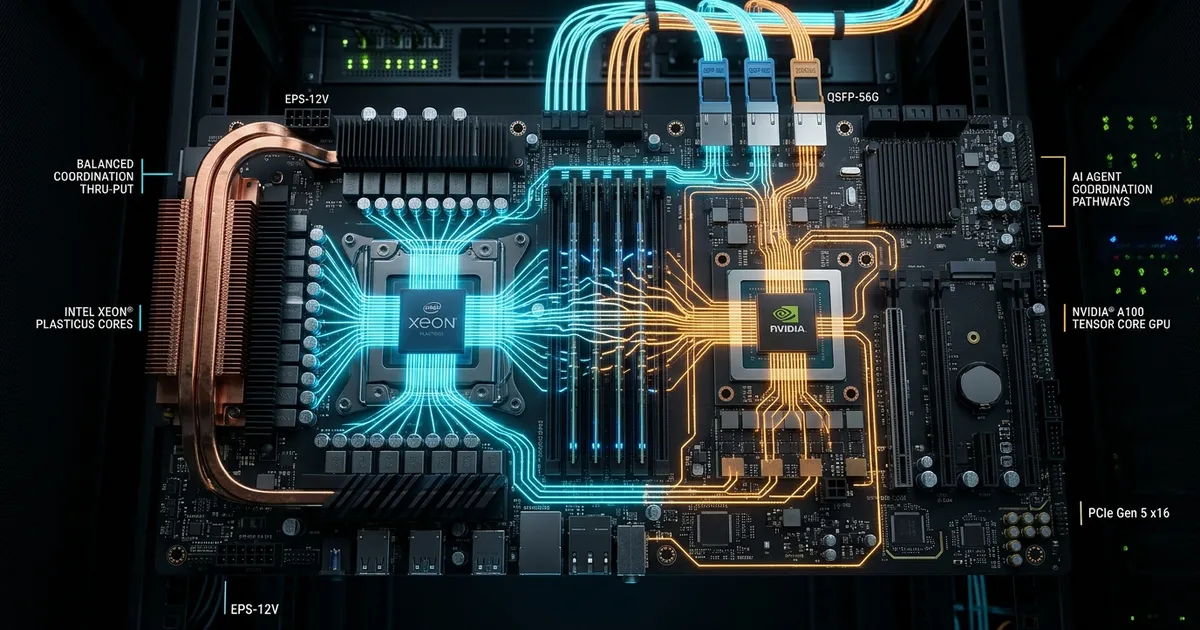
⚡ O Novo Equilíbrio da Computação de IA
- ▶Além da Inferência Pura: A IA agêntica não apenas devolve respostas em texto; ela planeja, consome APIs, executa código em terminais e orquestra bancos de dados em segundo plano.
- ▶O Rebalanceamento CPU / GPU: Ambientes tradicionais usavam 1 CPU para 8 GPUs. Fluxos agênticos complexos empurram essa relação para 1:1 devido à sobrecarga de orquestração.
- ▶Fim do Gargalo de Latência: Sem processadores centrais com alta densidade de núcleos e pistas PCIe rápidas, aceleradores gráficos caríssimos ficam ociosos aguardando dados.
- ▶A Nova Métrica de Eficiência: O sucesso nos datacenters modernos é medido pela vazão de tarefas (*Throughput*) por rack dentro de limites severos de fornecimento de energia.
A evolução da inteligência artificial dentro das organizações operou, até muito recentemente, em um modelo primordialmente reativo: o usuário digitava um comando (prompt) no navegador e o modelo devolvia um texto, resumo ou bloco de código em poucos segundos.
No entanto, o mercado corporativo está cruzando uma fronteira decisiva rumo à Era da IA Agêntica. Nesse novo ecossistema, o foco deixa de ser o atendimento a dúvidas pontuais e passa a ser a execução de fluxos de trabalho totalmente autônomos. Estamos falando de sistemas compostos por múltiplos agentes digitais especializados que raciocinam, consultam bancos de dados vetoriais, consomem APIs externas, executam rotinas em terminais shell e coordenam entregas complexas em segundo plano, sem a necessidade de intervenção humana a cada etapa do processo.
A Reconfiguração Oculta do Hardware
Essa mudança de paradigma autônomo altera drasticamente as exigências sobre a infraestrutura computacional dos servidores.
Historicamente, as implantações tradicionais de IA focadas puramente em inferência ou treinamento massivo operavam com uma proporção de 1 processador (CPU) para cada 4 ou 8 aceleradores gráficos (GPUs). Os processadores eram vistos quase como componentes secundários, encarregados apenas de alimentar a placa de vídeo com tensores e despejar o resultado final.
┌────────────────────────────────────────────────────────────────────────┐
│                   MUDANÇA DE PARADIGMA ARQUITETURAL                   │
│                                                                        │
│ MODELO ANTERIOR (Inferência Pura):                                     │
│ 1 CPU Central ──► Alimenta 8x GPUs em Paralelo (Foco 100% em Tensor)   │
│                                                                        │
│ MODELO AGÊNTICO (Sistemas Autônomos):                                  │
│ CPU Multithread (APIs, RAG, Bancos, OS) ◄── 1:1 ──► GPU (Modelos LLM)  │
│ (Alta Concorrência, Orquestração e Balanceamento de Latência)          │
└────────────────────────────────────────────────────────────────────────┘
Com a consolidação da IA agêntica, essa arquitetura está sendo empurrada para uma proporção muito mais próxima de 1:1. Em cenários corporativos de alta concorrência — onde dezenas de agentes realizam validações paralelas simultaneamente —, a demanda por recursos do processador central pode até mesmo superar a demanda de computação pura das placas aceleradoras.
O Fim do Monopólio da GPU
Por que os processadores potentes voltaram com tanta força ao centro das atenções? A resposta reside no ecossistema de software que envolve um agente inteligente.
A IA Agêntica não depende apenas da rede neural processando na GPU; ela depende de tudo o que orbita ao seu redor:
- Pipelines de RAG (Retrieval-Augmented Generation): Indexação, fragmentação de documentos (chunking) e buscas em bancos de dados vetoriais locais (como Qdrant, Chroma ou pgvector);
- Serviços de Orquestração: Gerenciamento de filas de tarefas, verificação de políticas de segurança, sanitização de saídas e chamadas de rede;
- Ambientes Isolados de Execução: Execução de scripts em contêineres Docker efêmeros para validação de dados em tempo real.
Se a CPU for subdimensionada, as GPUs de última geração passam preciosos milissegundos ociosas esperando o processamento das instruções de entrada. Isso gera gargalos severos de latência e eleva os custos operacionais da empresa às alturas.
A Nova Métrica de Eficiência nos Datacenters
Com centenas de instâncias agênticas exigindo alta densidade de processamento, avaliar servidores apenas pelo número de Teraflops da GPU já não reflete o retorno sobre investimento (ROI). Os datacenters lidam com restrições severas de espaço físico em rack, dissipação térmica e, sobretudo, limites de consumo elétrico (teto energético).
Por conta disso, a capacidade de throughput (vazão de dados e tarefas concluídas) por rack sob restrições reais de energia tornou-se a métrica de ouro do setor. Fabricantes globais de semicondutores, como a AMD e a Intel, estão redesenhando seus processadores para servidores (como as linhas EPYC e Xeon) com foco específico no balanceamento de largura de banda de memória e instruções dedicadas para alimentar clusters agênticos.
Escalando a Sua Própria Infraestrutura
A inteligência artificial transformou-se de um modelo empacotado em um sistema de computação distribuída. À medida que as empresas saem das fases de testes conceituais e entram em produção, equilibrar processadores com alta contagem de núcleos, discos NVMe velozes e boa largura de banda é o que determina o sucesso da implementação.
Se você está começando a estruturar os seus primeiros agentes locais, gerenciar bancos vetoriais ou automatizar rotinas de engenharia com scripts inteligentes, ter um servidor balanceado é o primeiro passo para não gerar gargalos na sua infraestrutura.
Para te ajudar a escolher máquinas com excelente equilíbrio entre processamento e custo na nuvem, confira a nossa seleção atualizada com as Top 5 Melhores Hospedagens VPS Baratas para Aplicações Web em 2026.
Thalisson
Criador de Conteúdo & PesquisadorProfissional de TI & Entusiasta de Tecnologia
Atua diariamente com tecnologia há mais de 4 anos, lidando na prática com rotinas de hardware, sistemas e desenvolvimento de software. Todas as análises e guias são baseados em pesquisas aprofundadas em fontes confiáveis e testes no mundo real.